O que é diarização e quando você precisa dela
Diarização responde "quem falou o quê". É uma tarefa separada da transcrição, cobra à parte e erra em lugares específicos que vale conhecer antes de integrar.
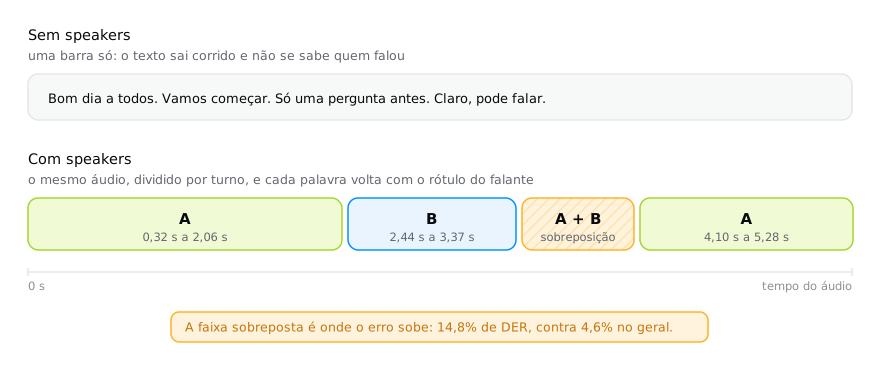
Transcrição responde o que foi dito. Diarização responde quem disse. São duas tarefas diferentes, resolvidas por modelos diferentes, e é por isso que ligar a segunda muda a tarifa e não melhora em nada a primeira.
Numa reunião de cinco pessoas, a transcrição sozinha devolve um bloco de texto corrido. Com diarização, cada palavra volta com um rótulo de falante:
"words": [
	{ "start": 0.32, "end": 0.78, "text": "Bom", "speaker": "A" },
	{ "start": 0.78, "end": 1.04, "text": "dia", "speaker": "A" },
	{ "start": 2.44, "end": 2.9, "text": "Vamos", "speaker": "B" },
	{ "start": 2.9, "end": 3.37, "text": "começar.", "speaker": "B" }
]
Os rótulos são anônimos por natureza: "A" e "B" são "a primeira voz" e "a
segunda voz", não nomes. Ligar rótulo a pessoa é trabalho seu, e normalmente vem
de fora do áudio (quem entrou na sala, quem estava no ramal).
Como pedir
Um campo só decide tudo:
| Valor | Significado |
|---|---|
| omitido | Texto corrido, sem separar falantes. |
true | Separa os falantes; a quantidade quem descobre é a API. |
3 | São exatamente 3 falantes. |
"2-5" | São entre 2 e 5 falantes. |
curl https://api.transcrevo.com/v1/transcripts \
  -H "Authorization: Bearer $TRANSCREVO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "url": "https://example.com/reuniao.mp3", "speakers": 5 }'
Só informe a quantidade quando você souber de verdade. Um palpite errado é
pior que não palpitar: ele força a separação para a contagem que você chutou, e
o sistema passa a dividir uma voz em duas ou juntar duas numa. Se você não sabe,
true deixa a decisão com quem tem o áudio na mão.
Onde a diarização erra
Nenhum sistema acerta sempre, e conhecer os buracos antes de integrar poupa tempo de depuração. Medimos os nossos em 216 arquivos, 19,6 horas de fala com anotação humana, pelo protocolo padrão de DER:
| Métrica | Valor |
|---|---|
| DER sem colar | 4,6% |
| DER com colar de 0,25 s | 2,8% |
| DER só na fala sobreposta | 14,8% |
| Contagem exata de locutores | 146 dos 216 arquivos |
DER (diarization error rate) é a soma de fala perdida, falso alarme e confusão de locutor sobre o tempo total de fala. Quanto menor, melhor.
Os dois lugares onde ele piora são previsíveis:
- Fala sobreposta. Duas pessoas falando ao mesmo tempo recebem um rótulo só. É a pior fatia do sistema: 14,8% de DER contra 4,6% no geral.
- Turnos curtos. Abaixo de 5 segundos ("sim", "uhum", uma pergunta rápida), o acerto de locutor cai para a faixa de 59 a 75%. Acima de 15 segundos, fica entre 95 e 99%.
Isso tem uma consequência prática: se o seu produto depende de contabilizar intervenções curtas (quem interrompeu quem, quantas vezes cada um falou), conte com erro nessa fatia. Se ele depende de blocos de fala razoáveis (ata de reunião, entrevista, podcast de duas pessoas), a diarização entrega.
O detalhamento completo, com JER, fala perdida e falso alarme separados, está em precisão e qualidade.
Quando não usar
Diarização custa mais: US$ 0,05 por hora de áudio contra US$ 0,03 da transcrição pura. Ela não deixa o texto melhor. Então:
- Não use para transcrever uma aula, um ditado, um recado de voz, um vídeo com narrador único. Um falante só não tem o que separar.
- Não use "por garantia" num lote grande. Numa fila de mil horas, a diferença entre as duas tarifas é US$ 20.
- Use quando o rótulo entra no produto: ata de reunião, entrevista, atendimento com cliente e agente, legenda que precisa identificar quem fala.
O campo speakerCount
Com speakers, a resposta traz speakerCount, quantas vozes distintas foram
encontradas. Vale notar a diferença entre null e 0: null é "você não
pediu", 0 é "pedi e não achei ninguém falando". Tratar os dois igual esconde
o áudio mudo, que é justamente o caso que você quer ver no log.