Como transcrever áudio por API, do zero ao texto
Três requisições HTTP transformam um arquivo de áudio em texto com timestamps. Sem SDK, sem fila para configurar, sem servidor de GPU.
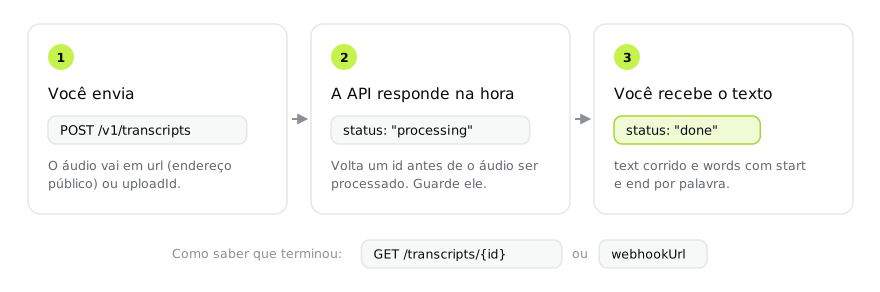
Transcrever áudio por API é mais simples do que a maioria das integrações faz parecer. São três requisições: uma para criar a conta e pegar a chave, uma para mandar o áudio e uma para buscar o texto. Nenhum SDK, nenhuma dependência nova no seu projeto, nenhum servidor com GPU para manter.
Este post mostra o caminho inteiro em curl, e depois os três detalhes que
costumam morder quem integra: o áudio que não está numa URL pública, a espera
pelo resultado e o custo.
1. A chave
Crie a conta e copie a chave que nasce com ela. Não pede cartão, e a conta já
vem com US$ 2 em créditos, o suficiente para cerca de 65 horas de áudio. A chave
vai no header Authorization em toda requisição:
export TRANSCREVO_API_KEY="sua-chave"2. Mandar o áudio
Se o arquivo já está numa URL pública (um bucket, um CDN, o enclosure de um podcast), uma requisição basta:
curl https://api.transcrevo.com/v1/transcripts \
  -H "Authorization: Bearer $TRANSCREVO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "url": "https://example.com/podcast.mp3" }'
A resposta volta na hora, antes de o áudio ser processado:
{
	"data": {
		"id": "6b9f2b81-1c9a-4f4e-9d5f-8f2a7c1e3b90",
		"status": "processing",
		"text": null,
		"language": null,
		"cost": 0,
		"model": "trv-1",
		"createdAt": "2026-09-01T18:00:00.000Z"
	}
}
Guarde o id. É por ele que você busca o resultado.
O áudio que não está numa URL pública
Arquivo local, ou num bucket privado, vai por upload. A API aceita o arquivo
inteiro numa requisição, e aceita em pedaços quando ele é grande ou a rede é
ruim: o envio em chunks retoma de onde parou em vez de recomeçar os 800 MB. Os
detalhes dos dois caminhos estão em envio de arquivos. O
resultado é o mesmo uploadId, que entra no lugar da url:
curl https://api.transcrevo.com/v1/transcripts \
  -H "Authorization: Bearer $TRANSCREVO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{ "uploadId": "upl_9f2b81c9a4f4e9d5" }'
3. Buscar o texto
O processamento é assíncrono. Consulte o id até o status virar done:
curl https://api.transcrevo.com/v1/transcripts/6b9f2b81-1c9a-4f4e-9d5f-8f2a7c1e3b90 \
  -H "Authorization: Bearer $TRANSCREVO_API_KEY"
{
"data": {
"id": "6b9f2b81-1c9a-4f4e-9d5f-8f2a7c1e3b90",
"status": "done",
"text": "Bom dia a todos. Vamos começar.",
"words": [
{ "start": 0.32, "end": 0.78, "text": "Bom", "speaker": null },
{ "start": 0.78, "end": 1.04, "text": "dia", "speaker": null }
],
"language": "pt",
"durationSeconds": 3,
"cost": 0.0025,
"currency": "USD"
}
}text é a transcrição corrida. words é o que serve para legenda, para busca
por trecho e para cortar o vídeo no ponto exato da palavra: cada palavra volta
com start e end em segundos decimais.
Não fique consultando em laço
Polling funciona para um arquivo. Para volume, ele vira custo de requisição e
atraso: você descobre que terminou no próximo tique, não quando terminou. Passe
webhookUrl na criação e a API chama você uma vez, quando concluir:
curl https://api.transcrevo.com/v1/transcripts \
  -H "Authorization: Bearer $TRANSCREVO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://example.com/podcast.mp3",
    "webhookUrl": "https://seu-servidor.com/hooks/transcrevo"
  }'
O corpo do webhook traz o id e o status, mas não traz text nem
words: num áudio de duas horas esses campos passam de 10 MB, e webhook não é
lugar de trafegar isso. Recebeu a chamada, busque o transcrito pelo id.
Os parâmetros que mudam o resultado
Quatro campos opcionais respondem por quase toda a diferença entre uma integração que funciona e uma que decepciona:
| Campo | Quando usar |
|---|---|
language | Quando você já sabe o idioma. Em áudio curto ou com ruído, a detecção automática erra mais do que você informando. |
speakers | Quando precisa saber quem falou o quê. Muda a tarifa, e não melhora o texto. |
glossary | Sempre que o áudio tiver nome próprio, marca ou jargão do seu domínio. É o maior ganho de qualidade por linha de código. |
webhookUrl | Sempre que houver volume. |
O glossary merece atenção. Nome próprio e anglicismo são o erro mais comum de
qualquer sistema de transcrição, porque são exatamente as palavras que não
aparecem no treino. Você passa o que ele ouve e o que deveria escrever:
{
	"url": "https://example.com/reuniao.mp3",
	"glossary": { "gatu": "Gatto", "bertual": "Bertuol" }
}
O que custa
US$ 0,03 por hora de áudio, cobrada proporcional ao segundo: dois minutos custam
US$ 0,001, não um centavo. Com speakers, US$ 0,05 por hora. O débito acontece
quando a transcrição fica done, e enquanto processa o cost é 0. Os detalhes,
incluindo o desconto automático acima de 10.000 horas, estão em
preços e limites.
O que dá errado
402 insufficient_balance: acabou o crédito. Nada é apagado, e a recarga automática existe para isso não acontecer no meio da noite.audio_too_long: o limite é 10 horas por arquivo. Divida antes de enviar.429 rate_limited: você passou de 120 criações por minuto. Espere e tente de novo.429 concurrency_limit: enquanto a conta roda só com o crédito de boas-vindas, no máximo duas transcrições ficam em processamento ao mesmo tempo. A primeira recarga tira o teto.
A lista completa de códigos está em erros.
Resumo
Uma chave, um POST com a url ou o uploadId, e um GET (ou um webhook)
para pegar o texto. O resto é opcional e existe para casos específicos:
speakers para saber quem falou, glossary para acertar os nomes, language
para não depender da detecção automática.