Como medimos a precisão em português, e por que WER de terceiro não se compara
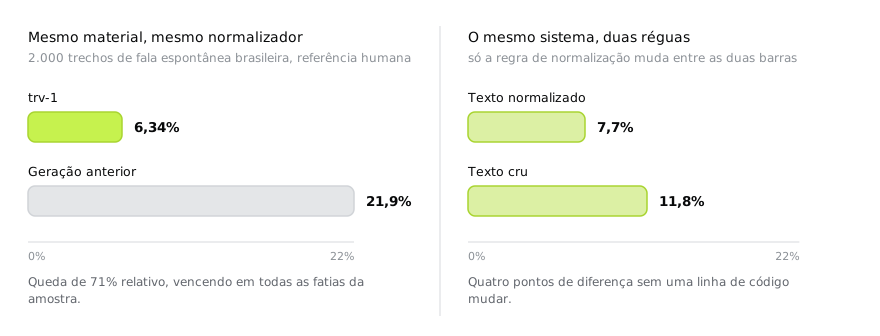
6,34% de WER em fala espontânea brasileira, medido contra transcrição humana. O número importa menos que o protocolo, e é o protocolo que quase ninguém publica.
Todo fornecedor de transcrição publica um WER. Quase nenhum publica como chegou nele, e é aí que o número deixa de significar qualquer coisa.
WER (word error rate) é
(substituições + deleções + inserções) / palavras da referência. A fórmula é
padrão. O que não é padrão, e move a métrica em vários pontos, é tudo em volta:
qual material foi avaliado e como o texto foi normalizado antes da comparação.
O que medimos
| Medida | Valor | Onde |
|---|---|---|
| WER em português do Brasil | 6,34% | 2.000 trechos de fala espontânea |
| DER de diarização (sem colar) | 4,6% | 19,6 h com anotação humana |
| DER de diarização (colar de 0,25 s) | 2,8% | 216 arquivos |
| Erro mediano do timestamp de palavra | 69 a 86 ms | áudio real, palavras casadas |
O material é fala espontânea brasileira: entrevista e diálogo real, estratificados por tipo de áudio e sorteados com semente fixa. Não é frase lida em estúdio, que é o material onde todo sistema parece excelente.
A referência é transcrição humana, não a saída de outro sistema. Comparar com outro modelo mede concordância, não acerto: dois sistemas podem errar a mesma palavra e o número sair ótimo.
A normalização, idêntica para todos os sistemas comparados: minúsculas, pontuação removida, dígito escrito por extenso, hífen vira espaço.
Por que a normalização decide o número
É o ponto que raramente aparece na página de marketing. O mesmo sistema, no mesmo material, marca 7,7% normalizado e 11,8% cru. Quatro pontos de diferença sem uma linha de código mudar, só pela regra de comparação.
Isso significa que comparar o WER publicado por dois fornecedores é comparar duas réguas diferentes. Se um deles remove pontuação e o outro não, o primeiro ganha por construção. Se um avalia frase lida e o outro avalia call center, o primeiro ganha de novo.
A única comparação que vale é a que você faz: mesmo material, mesmo normalizador, rodando o seu áudio nos dois. É exatamente para isso que a conta nova vem com crédito suficiente para umas 65 horas.
O que ainda erra
Publicamos os limites junto com os acertos, porque quem integra precisa saber onde conferir:
- Fala sobreposta é o pior lugar do sistema: 14,8% de DER nessa fatia contra 4,6% no geral. Duas pessoas falando ao mesmo tempo recebem um rótulo só.
- Turnos curtos, abaixo de 5 segundos, derrubam o acerto de locutor para a faixa de 59 a 75%, contra 95 a 99% nos turnos acima de 15 segundos.
- Nome próprio, marca e anglicismo são o erro mais comum do texto. São as
palavras que menos aparecem em qualquer treino. A correção é o campo
glossaryda requisição, que reescreve os termos daquele áudio. - Música de fundo às vezes vira texto: a letra é transcrita.
- A saída não é determinística. O mesmo arquivo pode voltar com diferenças
pequenas entre execuções. Não existe
seed.
Timestamps
Cada palavra volta com start e end em segundos decimais. O erro mediano
contra referência externa fica entre 69 e 86 ms, com 1,8% das palavras acima de
1 segundo de desvio num podcast e 3,1% num vlog com música. É precisão
suficiente para legenda e para cortar o áudio no ponto da palavra.
O que fazer com isso
Se você está avaliando fornecedores, o checklist é curto:
- Peça o material da avaliação. "Fala espontânea" e "frase lida" não são a mesma coisa.
- Peça o normalizador. Sem ele, o WER não se compara com nada.
- Peça a referência. Humana ou saída de outro sistema?
- Rode o seu áudio. É o único teste que responde a sua pergunta.
Os números desta página, com o detalhamento por fatia, estão em precisão e qualidade e são atualizados quando a medição é refeita.